你没敲的上下文
用 Claude 与 Claude Code 当 worked case,给组装上下文的内容分类来源,第一方文档、分布式软件、第三方提取分开。
大多数用户心里的模型长这样:
用户
 ↓
模型
 ↓
回答
消息进去,智能发生,回答出来。第 2 章用核算表说明这个图为什么不可靠——它描述不了系统组装了什么。本章展示机器。生产助手背后站着运行时,从几个来源组装上下文,用户消息只是其中之一。
第 2 章让组装的上下文在边界可观测。本章问内容从哪来。它给来源分类,还不做任何判定:分配是第 4 章,顺序是第 6 章,工具是第 17 章,权威性是第 19 章,组装是[第 23 章](/zh-cn/books/context/23-chapter/)。
worked case 是 Claude 与 Claude Code。选择是方法的。Anthropic 按模型发布聊天应用系统提示词,文档写 Claude Code 怎么加载项目指令,写它的上下文工程 practice,Claude Code 以可检查的软件分发。独立的提示词字符串提取提供更低置信的另一视图。合起来支撑有文档机制与可见 artefact 的 case study,不重建任何特定 provider 请求。这不是厂商排名;后面的章节在机制有文档处用别的 provider。
知道什么,怎么知道的
关于 Claude 上下文的断言来自 standing 很不同的三种来源,永不混合。规则是证据只确立来源允许的东西。
**第一方文档。**Anthropic 发版注按模型发布 claude.ai 网页与移动应用的核心系统提示词,并说这些不适用于 API。Claude Code 文档描述项目指令文件怎么加载。工程 essay general 地描述 practice:上下文工程 essay 把上下文定义为采样时纳入的 token,描述压缩、结构化记笔记、just-in-time 检索,工具 essay 说工具描述加载进智能体的上下文。这些材料确立 Anthropic 说了什么,对它点名的产品、界面、时间。它没确立 Claude Code 每次调用发什么。
**分布式软件。**Claude Code 以可安装软件 ship,指定发行版里找到的提示词字符串、工具定义、harness 行为是该 release 的第一方 artefact。在场确立 artefact 含某机制或分支,不确立某会话里分支跑了。静态 artefact 也确立不了服务器加了什么、provider 最终收到什么、作者为什么这样实现选择。基于检查的断言因此须点名版本与检查的 artefact。
**第三方提取。**仓库 Piebald-AI/claude-code-system-prompts 从 Claude Code 编译源提取提示词字符串,跨 release 跟踪。检查时三百版本五百多字符串。工作 diligent,它不是 Anthropic 出版物。它能确立它的方法与快照下提取 artefact 的属性。它自己的注说逐字符串 token 数是近似。它展示不了任何特定调用含什么、哪些分支跑了、服务器侧发生什么、Anthropic 把什么当 guidance,那里找到的字符串没有一句当 Anthropic doctrine 引用。
本章用到哪就区分三证据层级。三样单独没有一样是真实 provider 请求的捕获。文档描述支持的行为,发行版含可能的实现路径,提取暴露发行版里的一些字符串。哪些路径跑了、宿主组装了什么、provider 最终渲染什么,要在显式点名的边界追加观察才确立。
栈
来源固定了,概念模型。下面表给能贡献一次组装上下文的来源分类。
**栈是来源的分类。它不是渲染顺序、组装顺序、权威性排名。**某层的排布有文档处,正文另说。
| 层 | 谁贡献 | 怎么进入 | 何时变 |
|---|---|---|---|
| 厂商与模型指令 | 模型 provider | 系统提示词(聊天应用已发布) | 模型或产品版本变 |
| 产品与 harness 指令 | Harness 作者 | 系统提示词,带条件分支 | harness 发版或配置不同 |
| 项目与用户指令文件 | 仓库与用户作者 | harness 加载;Claude Code 里以系统提示词后的消息交付 | 文件变;有的按需加载 |
| 环境状态 | 运行时 | harness 渲染;内容不定 | 环境变 |
| 工具定义与 schema | 工具与 harness 作者 | 随请求供给 | 可用工具变 |
| 条件提醒 | Harness 规则 | 条件命中时注入 | 条件触发 |
| 对话 | 参与者,经 harness | 逐轮追加 | 轮次增加、替换或压缩 |
| 摘要 | 运行时,用模型 | 替换早期历史 | 压缩再生它们 |
| 工具结果,含文件读取 | 工具,智能体调用时 | 返回进对话 | 工具跑 |
| 当前用户输入 | 用户 | 新一轮 | 新一轮到来 |
“何时变"列是 lifecycle,不是测得的易变排名。任何层都能会话中途变:项目文件能编辑,工具集能动态注册,历史能压缩。
栈三属性值得说。第一,贡献、传输、渲染位置回答不同问题。项目指令作者可能是仓库维护者,harness 以系统提示词后的用户 role 消息交付,按 Claude Code 的文档。它的传输 role 因此标识不了作者,也没赋予它新鲜用户请求的权威性。第二,这不是通用栈。bare API 调用可能省略大半层;多智能体 harness 可能加层。第三,分类本身标识不了捕获调用里哪些层在场。教训不是这张表。而是这句话:
组装的上下文是多来源 artefact,没有单一作者。
    flowchart LR
    P["Provider 与产品"] --> A["运行时组装"]
    F["项目文件"] --> A
    T["工具"] --> A
    H["历史与摘要"] --> A
    G["智能体生成的 state"] --> A
    U["用户"] --> A
    A --> O["观察边界<br/>(宿主的模型-上下文 hook)"]
    O --> X["Provider 翻译"]
    X --> M["Provider 与模型"]
用户供给一来源。运行时供给别的,工具供给别的,过去的计算供给别的。有的被选,有的被变换,有的被生成,有的是条件的。能贡献上下文的机器大半在用户消息之外。下面的例子测量一捕获表示;它没确立典型会话的成分。
建上下文检查器
Claude Code 的 /context 提示了有用的呈现:容量条加占据它的 breakdown。我们能用[第 2 章](/zh-cn/books/context/02-chapter/)的捕获流水线自己建。输入是捕获调用,解析器把 parts 派到类别,渲染器生成显示。输入变,图变。
Context inspector 例子拿作者本地会话的现存 OpenCode 捕获。源文本保密;结构核算与生成的视图批准发表。这是为演示工具选的一次调用。它的目的与采样史 unclassified,所以它不估计这个成分在日常工作里多久出现。
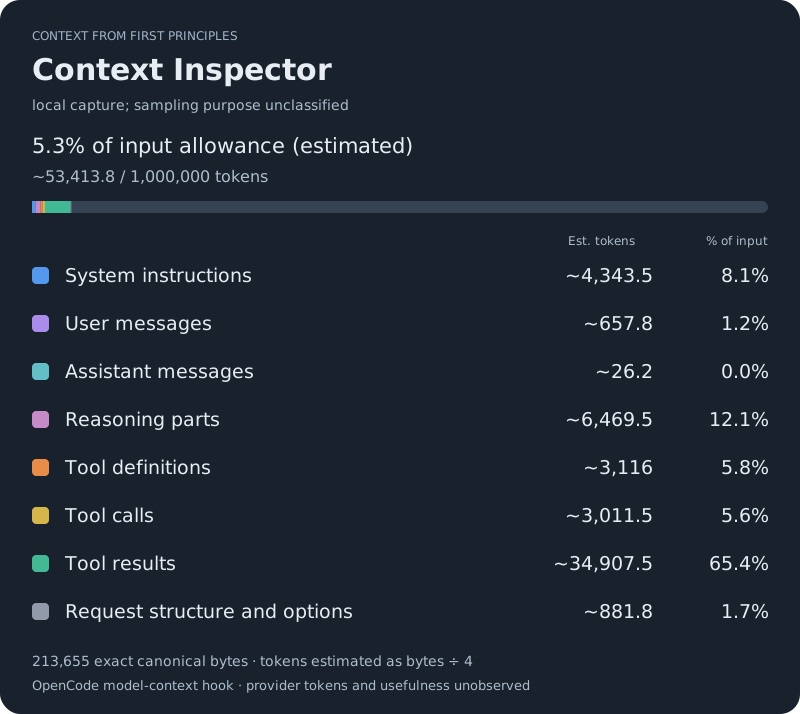
解析器跟记录的结构,不从散文猜来源。系统条目计入系统类别;用户 role 文本 part 计作用户 role 材料,哪怕 harness 插的;工具结果 part 计作工具结果。工具定义有自己的类别。不认识的 part 留在 Other。这些是对捕获形式的分类,不是对人类用户、厂商、项目或运行时的 verified 归因。解析器不扫 “Memory”、“Skills” 之类的标题当来源误认。捕获没有可信来源标识处,来源保持 unattributed。
计数要表示。这里是捕获的系统、消息、工具、请求选项的 canonical JSON,UTF-8 编码。每系统条目、消息 part、工具定义条目数一次。JSON 框架、消息 metadata、请求选项占剩下类别,字节 total 对那个 canonical 编码 reconcile。完整的工具 part 含捕获的输入 metadata 和输出。reconciliation 证明这个表示的内部一致;它不证明捕获含 provider 请求的每份贡献。这些是本地编码的精确字节数,不是 provider 的线路格式或分词器输出。
教学实现按字节除四估计 token。第 2 章解释这类估计为什么要 qualification:JSON 语法、metadata、非文本 parts 在 provider 那里表示可能不同。每 token 数,含估计占用与 headroom,都带估计 label,绝不当 provider 数呈现。allowance 来自捕获的模型 metadata(显式有输入 allowance 处),或读者输入的预算。读者给的预算是声明不是观测。两者都不给输入 allowance,显示报告成分而不发明 headroom;模型的 total 上下文窗口不静默当可用输入预算。
核算检查坐在解析与显示之间:
from project_context.debugger.panel import build_panel, select_capture

capture, load_status = select_capture("captures.jsonl")
report = build_panel(capture)
assert sum(row["bytes"] for row in report["categories"]) == report["total_bytes"]
研究仓库里的完整命令从同一核算生成交互 HTML 视图、figure、底层报告:
contextlab debug panel captures.jsonl \
  --output .local/inspector/index.html \
  --svg-output .local/inspector/context.svg \
  --json-output .local/inspector/report.json
能选显式调用而不取最新。HTML 视图让读者展开类别,按消息与 part 号定位贡献,带字节数。源文本与私有名字这些视图里省略。存下的报告是 figure 背后的可检查路径,捕获变,三输出全再生。
这次调用里工具结果占计数表示的最大 share。这给出检查处。它不说明那些结果无关或删掉安全。deferred 定义、压缩预留、provider 加的材料还是没观测,不会冒充发明的行。仪器让大贡献可见;后面的对比决定改变它是否有帮助。
在 Context Viewer 里检查
同样的批准核算驱动本章的 Context Viewer scene:相同的类别字节,相同的估计 token 标注,相同的没观测清单。打开 scene 按消息与 part 号展开工具结果贡献,再检查 viewer 拒绝说什么——无相关性 verdict、无有用性断言、无典型会话 generalization。viewer 是检查器长成 lifecycle 仪器;后面的章节一次揭示一能力,从预算到交付,数字不变。
逐层看
**厂商与产品指令。**已发布的聊天应用提示词展示 genre:身份、日期信息、格式约定、行为默认。对那些界面,它们是唯一能从第一方来源 verbatim 引用的层,发版注提醒提示词是版本化 artefact。Claude Code 自己的产品指令不在那个出版物里,聊天应用提示词不能读成 Claude Code 的。提取展示的是结构:子智能体、斜杠命令、摘要、工具的上百 distinct 字符串,说明这个客户端里"系统提示词"是组合组装,不是一段话。
**项目指令文件。**Claude Code 的文档说工作目录及上层目录的 CLAUDE.md 之类的文件启动时加载、concat 进上下文,子目录的文件在 Claude 读那里文件时加载,和对话一起耗 token。它还说这些指令是上下文,不是强制配置。AGENTS.md 处理不同:当前版本只在没有 CLAUDE.md 时默认直接读它,两文件不等价。结构 point 是 durable 项目材料经运行时规则变成逐调用上下文。每相关调用都收的文件在组装上下文里有 recurring 成本,这就是这层后面在预算、持久化、准入里重要的原因。
**环境状态。**运行时可能插入智能体运行环境的事实,比如工作目录、平台、仓库状态。这里用的来源没确立 Claude Code 跨版本配置渲染的确切环境块。环境状态因此是分类里的候选来源类,不是测得的 Claude Code 贡献。检查器只有捕获含可信来源信息才把这类材料归因到运行时;散文里出现路径或平台名不够。
**工具定义与 schema。**Anthropic 的工具 essay 说工具描述加载进智能体的上下文,集体 steer 行为,太多或重叠的工具 distract 智能体偏离高效策略。所以工具设计一半是上下文设计。提取展示很多工具相关字符串,确立客户端含大提示词 surface。它没确立每次调用全付了,因为组装是条件的。第 17 章把工具当上下文讲全。
**条件提醒。**条件命中时注入的指令。它们证明上下文能无新用户请求就变,transcript 很少标记哪些提醒触发了。条件提示词存在不说明条件触发了、组装了、provider 收到了、行为变了。这就是第 2 章的观察器每调用记一条并对比,不 assumed 固定 preamble 的原因。
**对话、摘要与工具结果。**对话历史逐轮累积。工具结果(命令输出、搜索命中、文件内容、报错轨迹)返回进对话,按需读的文件这样到来,所以检索到不等于准入:检索文件只在 harness 把返回的东西放进调用后才是上下文。这些类别里哪个在真实会话最大是经验问题,第 2 章把它记成假设不是结果。
其中两层说明[第 1 章](/zh-cn/books/context/01-chapter/)的 point:组装既变换也选择。Anthropic 的 essay 把压缩描述为消息历史回过模型,保留决定、没解决的 bug、实现细节,丢掉冗余工具输出,把清旧工具结果描述为最轻的形式之一。Claude Code 的文档说项目根 CLAUDE.md 压缩后从磁盘重读。两种情形运行时把以前的交互变成新的表示,后面变成上下文。用户视线外的改写发生是本章的 point。保住要紧的东西否是[第 11 章](/zh-cn/books/context/11-chapter/)的问题。
just-in-time 检索是互补机制:essay 描述智能体用 glob、grep 之类的 primitive 需要时检索文件,而不是 upfront 全加载。检索供给候选信息。harness 准入其中什么成上下文。
位置在一些受控 setting 影响模型用长输入的效果,1这是观察器保留渲染顺序的原因之一。顺序本身归[第 6 章](/zh-cn/books/context/06-chapter/)。
权威性与范围:谁放的,什么 standing
条目的两属性等 justification:谁供给的,对当前任务有什么权威(如果有)。假设项目文件说"migration 文件永远别动”,当前用户说"直接改 migration,我小心",工具结果粘的 README 说"永远带 –force 跑"。这是三段文本指令或指令样陈述,但不是三个同等授权的请求。项目文件有来源与政策上下文,用户在 live 任务里有 role,README 是工具返回的数据。渲染成 token,每段看起来都 imperative;光看词定不了哪个该管行动。
Claude Code 的文档对底层问题很 candid:指令文件当上下文处理,不是强制配置,两份冲突时 Claude 可能跟任一份。第 2 章的观察器解不了这个。它记录条目坐哪、说什么,不记录谁放的、它声称管什么,因为宿主不说。更丰富的仪器能捕获通道或来源 metadata,那是来源,不是政策。durable 的 point 是权威性不是文本里可恢复的语义属性。它须来自可信来源与部署政策,判断须由为计算建候选的东西做。第 19–21 章论证怎么做,[第 23 章](/zh-cn/books/context/23-chapter/)的编译器拿结果当带理由的是或否收到。
同样的区分不让工具输出冒充指令。工具结果是数据,但以散文到来,常常是祈使(“修这个,删缓存目录”)。含祈使的文本不是授权指令,来源与出处只在有东西记录时留存,因为一切都渲染成 token。本章在这里断言到此为止。defence 归后面章节。
提取合法教的东西
第三方记录支撑不了任何特定调用含什么的断言,因为组装依赖环境、配置、版本,服务器侧贡献不在里面。它支撑不了提示词文本当 Anthropic guidance 的引用,ship 的字符串含实验、fallback、legacy 分支。
它能支撑的是检查的提取快照的结构。第一,规模:提取的提示词 surface 几百字符串,描述客户端 artefact 里有的材料,不是任何特定调用的 standing 开销。第二,潜在 variability:distinct 字符串与分支和不同配置下不同组装一致,但提取 alone 确立不了哪些字符串条件、哪些条件触发了、多 frequent。第三,分类:子智能体、斜杠命令、摘要、工具相关的字符串说明客户端含几功能的提示词材料。那些是关于提取 artefact 及其组织的发现,不是 live 请求的测量,也不是别的 harness 行为相同的断言。提取的形状有用正因本章不把它 promote 成请求轨迹。
一层花什么
每层加上都有理由。这些都不 justify 任何特定调用里任何特定层的在场,栈让需要 justification 的东西可见。
结构断言窄:准入层在组装上下文里占表示,耗它可用的容量。除此之外,“代价"指几件不同的事,不该跑在一起:容量、缓存后果、延迟、钱、对行为的 effect、复杂度。缓存后果 provider-specific。OpenAI 的文档对一家 provider 说复用要求整个渲染前缀匹配,早变的层减少后面的复用,稳定的层支撑复用。某层帮不帮某轮的行为是独立问题,只有对比回答。
隐藏栈是很多手隐式做的预算分配:厂商工程师、harness 作者、工具设计者、写项目文件的过去的自己、智能体早轮。没有单一 actor 必然看到组装 total。
测什么,不测什么
一种可能的实验逐层加,从单指令经项目规则、工具定义、环境状态、历史、检索材料,测代价与行为。那不是这里提议的研究。每加一项同时改变可用信息与表示大小,这种对比 isolate 不了层的来源或排布的 effect。 targeting 那些属性的实验须任务相关内容固定,只变研究的属性,说清 manipulation 实际改了什么。
本章要的是描述性的,把栈变成测量 schema:捕获真实组装上下文,按层报告成分。观察器今天只能分开一些层。它记录工具定义、工具调用结果带工具名,消息按 role,能识别压缩请求。它不在厂商、产品、项目指令之间分系统块,项目文件来源由 operator 声明不推断。权威性范围根本不记。成分研究须用捕获支撑的类别,说清哪些不能。本章 Context inspector 例子演示一现存捕获的核算。它没把会话 enroll 进生态语料(还是空的),没确立典型成分。
上下文有很多贡献者,一有限终点。下一章把终点显式化:
上下文窗口是预算。
参考
- Anthropic. “Commands.” Claude Code documentation, verified 15 October 2026. First-party documentation;
/contextis the presentation precedent, not the source of this example’s counts. - Project Context. Context inspector example. Author-approved structural accounting of one captured invocation, frozen October 2026 and named in the companion repository’s evidence register. Canonical byte counts and an explicit token approximation; source capture private, sampling purpose unclassified, no behavioural or prevalence claim.
- Anthropic. “How Claude remembers your project.” Claude Code documentation, verified September 2026. CLAUDE.md and AGENTS.md loading, delivery as a user message after the system prompt, on-demand loading, re-reading after compaction, instructions treated as context and not enforced configuration. First-party; version-sensitive. https://code.claude.com/docs/en/memory
- Anthropic Applied AI team. “Effective context engineering for AI agents.” Published 29 September 2025. First-party engineering writing. CLAUDE.md loaded up front; just-in-time retrieval; compaction; tool result clearing. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic. “System prompts (release notes).” Official documentation, verified September 2026. Per-model published prompts for claude.ai and the mobile apps; not applicable to the API. https://platform.claude.com/docs/en/release-notes/system-prompts
- Anthropic. “Writing effective tools for agents — with agents.” Published 11 September 2025. Tool descriptions loaded into agent context; too many or overlapping tools can distract agents. https://www.anthropic.com/engineering/writing-tools-for-agents
- OpenAI. “Prompt caching.” Official documentation, verified September 2026. Prefix-match requirement. Provider-specific. https://developers.openai.com/api/docs/guides/prompt-caching
- Piebald-AI. “Claude Code System Prompts.” Third-party extraction repository, checked September 2026. More than five hundred prompt strings across about three hundred versions; token counts approximate. Structural evidence only; not an Anthropic publication. https://github.com/Piebald-AI/claude-code-system-prompts
-
Liu, N. F., Lin, K., Hewitt, J., et al. “Lost in the Middle: How Language Models Use Long Contexts.” Transactions of the Association for Computational Linguistics 12 (2024): 157–173; arXiv:2307.03172 (2023 preprint). Peer-reviewed. Position sensitivity in specific controlled tasks. ↩︎