多不更好
把容量和有用性分开:受控研究关于长输入、干扰、位置说明了什么,对智能体没说明什么,本书怎么测迁移。
诱人的假设是这样的。有用的信息好。模型有空容量。所以加更多潜在有用的信息应该更好,最差无害。在这个推理上建系统很容易:整个仓库倒进窗口以防万一,每个检索文档都留着(检索既然返回必有原因),历史永不截断(旧东西也许重要)。预算章说明准入花容量和钱。本章问它会不会花行为。
命题很窄。请求留在硬容量里,加的上下文也能降低测得的任务性能。它不是说更多上下文坏,不说存在上下文总伤人的长度,不说一机制解释失败。容量和行为效用是不同属性,在场不保证用好。本章 review 受控证据,标出证据止处,说清本书自己测什么。
四种状态,不是一种
“模型处理了上下文"把四种须分开的状态混在一起。它们是指定评估下的操作状态,不是信息的属性。它们也不保证是一过程的阶段:模型可能答对而随后问及时认不出支撑段落,直接检索探针可能改变测的任务。
**在场(Present)。**要的信息在第 2 章的观察边界的组装上下文里。这是包的属性,检查确立。
**可定位(Locatable)。**测试条件下模型能恢复或认出相关信息。这是行为测量。
**可用(Usable)。**测试条件下模型把信息正确用到要求的推理或行动。这是行为测量。
**有帮助(Helpful)。**纳入信息(或含它的上下文条件)相对恰当对比改善所选端到端结果。这是比较结果。
这些状态区分评估者能问的问题,不形成逻辑必然的 progression。成功的端到端回答不必蕴含独立的显式定位探针成功,成功的定位探针不证明正确应用。状态还给出诊断流程,不是因果分类。失败了先检查捕获里在场否,记住在场确立在宿主观察边界而不是 provider 处。在场,直接问事实测新条件下的可定位;成败本身诊断不了原来的尝试。孤立给事实探应用,上下文变了;孤立成功、整包失败和干扰一致,但 isolate 不了病因。拿掉事实的包对比探那个对比下的有帮助,但删除也改 token 数、渲染位置、连贯性。每探针和 control 一起解释时收窄可能的解释;没有一个单独认出机制。
    flowchart TD
    F["任务失败"] --> A("在场?<br/>检查包。")
    A -->|no| A0["缺席证据"]
    A -->|yes| B("可定位?<br/>直接问时模型找得到吗?")
    B -->|no| B0["和可定位失败一致"]
    B -->|yes| C("可用?<br/>事实孤立时用得了 facts 吗?")
    C -->|no| C0["和可用性失败一致"]
    C -->|yes| D("有帮助?<br/>整包打赢没事实的包吗?")
    D -->|no| D0["这个对比下没证明有帮助"]
    D -->|yes| D1["这个对比下有帮助"]
不同现象,不是一种
“更多上下文"打包几个机制不必共享的东西。溢出是硬容量失败。包大本身不确立臃肿:本书操作定义下,材料只有在去掉或替换后要求的行为保留、资源用得更少,才是臃肿。干扰是在受控对比下,加或改周围材料伴随的行为退化,任务相关证据与评估目标尽量固定。位置敏感是同样相关内容移动时的行为差。长度相关退化是定义评估条件下跨输入长度的测得下降。更长的输入不一定是更多干扰、不同位置、更难任务,文献警告别给每个下降派单解释。
Lost in the Middle 说明了什么
领域先伸手的研究是 Liu 等的 “Lost in the Middle”,名气超范围。作者测当时语言模型的多文档问答与键值检索,输入里移动相关信息。相关信息在开头结尾时性能常常最高,中间大幅掉,包括为长上下文建的模型。论文 2024 年发在期刊,2023 年预印本在前。
总体是问答和检索,模型是当时那代。没研究带工具的智能体,模式是那些任务里的 U 形,不是所有模型所有长度的 law。qualification 后留下的是 dissociation:那些条件下信息每条件都在场,行为还是不同。渲染位置能行为相关。本章到这里就够,第 6 章接顺序。
针之外:RULER
Hsieh 等的 RULER(COLM 2024)把针测试扩展:针类型数量多变,加多跳跟踪与聚合任务。十七个长上下文模型上十三任务,长度复杂度可配。作者报告朴素针测试近乎完美,大多数模型随长度复杂度涨大掉,每个模型都声称 32K token 以上上下文,只有一半在 32K 保持 satisfactory。 “satisfactory” 是作者的标准,总体是 2024 代。教训是简单检索测试的成功没 carry 到更难的用法。
应用任务分歧:HELMET
Yen 等的 HELMET(ICLR 2025)在七个应用中心类别、128K token 长度上评估 59 个长上下文模型。中心发现是合成任务(针检索)不可靠预测下游性能,各类别趋势不同、类别间相关低。长上下文能力因此不是一个可测的量,一任务一类别的结果不能代表另一个。任务还是 benchmark proxy,不是智能体轨迹。
针不像问题时:NoLiMa
几个熟悉的检索测试沾了问题与证据的字面重叠的光,但那不是关于前面研究里每任务的断言。Modarressi 等的 NoLiMa(ICML 2025)最小化这种重叠,答题须推断 latent 关联。十三个声称至少 128K 上下文的模型被测。1K token 下好得多。32K 十一个掉到自己短上下文基线的一半下,GPT-4o 从 99.3 掉到 69.7%。作者报告推理增强模型和思维链提示词也 struggle。他们提示没字面匹配时检索证据随上下文变难,同时说更深的机制分析超范围。本书采用报告的行为对比,不采用内部病因的 proven 解释。
NoLiMa 还定义有效长度(effective length):模型拿到自己短上下文 base 分数至少 85% 的最大测试长度。那是一种操作化,RULER 的 “satisfactory” 是另一种。本书用有效长度只带 benchmark 和阈值,因为它是模型在标准下的属性,不是 provider 发布的东西。
长度、干扰与结构:context-rot 报告
Hong、Troynikov、Huber 的报告 “Context Rot”(Chroma,2025 年 7 月)在难度固定的任务上测十八个模型四家族,输入长度变。它是公司技术报告,没同行评审。它提供和同行评审研究一致的额外受控证据,模型 specific 的结果当技术报告发现对待,等独立复现。
它的 manipulation 当类别有用。干扰(distractors) topical 相关但不回答问题,无关内容和两者都无关。针扩展里,一干扰相对纯针基线降性能,四个降更多,effect 随干扰与模型变,无关 filler 也 degrade 性能。相关与无关的添加材料产出不同的退化模式,够把两种 manipulation 分开。报告没确立两种内部机制。
三个结果这里 bounded。对话记忆测试里,只相关材料的提示词平均约 300 token,全历史提示词约 113K,模型在聚焦版上更好,推理模式缩小 gap 但没关上。答案两条件都在场,所以是在场无帮助,但两条件长度和无关材料量一起变,对比分离不了它们。模型在打乱 haystack 上比连贯的好,说明 filler 的结构不能 assumed 中性,作者机制 unresolved,这个发现不能读成"连贯 filler 有害”。最后报告描述不同模型失败方式不同,有的 abstain,有的自信答错。durable 的教训是测量的:终精度藏不同的失败签名。
作者直说不解释退化背后的机制。
Context rot 是现象
Context rot 在这里是模式的描述名:指定评估条件下所选行为度量随输入变长下降。Anthropic 的文档用这个词说精度与回忆随 token 数 degrade。模式没确立长度本身是因果变量,干扰、位置、结构、任务难度一起变时尤其如此。检索难度、干扰、位置、表示、干扰、模型 specific 行为还是候选解释。Anthropic 的工程指南用有限注意力预算框定上下文选择;本书拿它当有用的设计语言,不当测得的量或 demonstrated 的机制。
文献对比按每研究让读者结论什么组织:
| 评估 | 总体 | Manipulation | 结果 | 支持 | 不支持 |
|---|---|---|---|---|---|
| Lost in the Middle (Liu et al., TACL 2024) | 2023 年模型;问答、键值检索 | 相关信息的位置 | 检索与问答精度 | 位置能影响在场信息的成功使用 | 通用 U 形,或对智能体的 effect |
| RULER (Hsieh et al., COLM 2024) | 17 个模型;13 个任务 | 长度、任务类型、复杂度 | 任务精度 | 简单检索成功没 carry 到更难任务 | 每模型单可用长度 |
| HELMET (Yen et al., ICLR 2025) | 59 个模型;7 个类别 | 长度、任务类别 | 类别分数与相关性 | 合成分数不可靠预测下游分数 | 所有合成测试都没信息 |
| NoLiMa (Modarressi et al., ICML 2025) | 13 个声称至少 128K 的模型 | 字面重叠最小的长度 | 对短上下文基线的精度 | 没字面匹配时 32K 大掉 | 作者的注意力解释 |
| Context Rot (Hong et al., Chroma 报告,2025) | 18 个模型;4 家族 | 长度、干扰、结构、聚焦 vs 全量 | 任务精度、abstain | 相关与无关添加退化不同;结构不中性 | 机制;独立复现 |
失败词汇
四词操作定义。它们是诊断维度,不是互斥的箱子,也不是因果机制。一失败能同时占几个,过时条目也能是干扰,压缩损失能制造缺席,位置能和干扰互动,小上下文里也能干扰。
- **溢出(Overflow)。**请求超硬容量约束,被拒、截断或 halt。它是可观测属性,是[第 4 章](/zh-cn/books/context/04-chapter/)的地盘。
- **臃肿(Bloat)。**去掉或替换后要求的行为保留、上下文资源用得更少的材料。这让臃肿反事实、可测。[第 2 章](/zh-cn/books/context/02-chapter/)仪器检出的重复、没用的内容、稳定但没检查的条目是臃肿候选,不是 proven 臃肿,看着没用的条目也能改变行为。
- **干扰(Interference)。**受控对比下,加或改周围上下文伴随的行为退化,任务相关证据与评估目标尽量固定。manipulation 包括无关 filler、topical 相关材料、近 miss 干扰。词命名观测的 effect,不命名产出它的内部机制。
- **位置敏感(Position sensitivity)。**相关内容在渲染上下文里移动时的测得行为变化,内容 hold constant,别的变化最小化并报告。
从业者诊断分类
Breunig(2025)认出智能体会话里上下文累积时从业者遇到的四种失败模式。这里当诊断框架呈现,不当四个独立因果机制。类别重叠:poisoned 摘要能制造 clash、触发 distracting 检索、导致重复坏动作。它们是有用的描述,不是划分。
- **上下文中毒(Context poisoning)。**错误信息进上下文影响后面的决定。DeepMind Gemini 2.5 技术报告记录智能体的目标节被 misinformation 腐蚀,追不可能的目标。报告把重复动作行为定性为 anecdotal;它不是 general 阈值。
- **上下文分心(Context distraction)。**累积历史干扰规划推理。同一报告观察约 100,000 token 后智能体 favor 重复历史动作而不是合成新计划,描述为 anecdotal 观察。Databricks 长上下文 RAG 性能研究(2024 年 8 月)报告研究的配置下 Llama 3.1 405B 平均性能约 32K token 后开始降;这是 2024 RAG 发现,不是 general 智能体上下文上限。
- **上下文混淆(Context confusion)。**无关材料(尤其不必要的工具定义)导致错误决定。Berkeley Function-Calling Leaderboard 记录复杂度不同的函数调用任务上模型性能差,含多调用并行调用、无关检测。这些对比 motivate 调查工具选择失败,但本身 isolate 不了暴露额外工具定义的因果 effect。Paramanayakam 等(2025)证明量化的 Llama 3.1 8B 在 46 工具定义的 GeoEngine 任务挂、19 个过,同一上下文窗口内;这是特定模型 benchmark 例子,不是 19 或 46 工具的 general 阈值。
- **上下文冲突(Context clash)。**冲突信息或以前的假设 disrupt 后面的推理。Laban 等(2025)说明把完整指定的提示词 shard 成多轮交换(模型没拿到全部信息就 premature 尝试)按作者的平均 39% 相对退化(六任务家族,15 个模型)降性能。模型 anchor 在自己早答案上。
这四个描述映到本书更精确的词汇:poisoning 是来源与状态失败(第 11、15 章);distraction 是干扰与位置敏感(本章、[第 6 章](/zh-cn/books/context/06-chapter/));confusion 是能力面臃肿与无关候选准入(第 14、17 章);clash 是权威性与事实冲突([第 19 章](/zh-cn/books/context/19-chapter/))与时间不一致([第 20 章](/zh-cn/books/context/20-chapter/))。分类是实践入口;选择、表示、组装、权威性、行为评估的区分还是分析地基。
相关维度归后面章节,不取代这个词汇。上下文条目之间的冲突是[第 19 章](/zh-cn/books/context/19-chapter/)的,过时是[第 20 章](/zh-cn/books/context/20-chapter/)的,经删除变换的损失是[第 11 章](/zh-cn/books/context/11-chapter/)的。本章研究添加的材料。
迁移到智能体
这里 review 的证据大半用合成检索、问答或其他有界 benchmark 任务,不是带工具跨轨迹 operat 的编程智能体。HELMET 含应用导向评估,但还是 benchmark proxy,不是本书要研究的智能体 workflow 的观测。下面的迁移断言因此是假设,不是结论。
**本书假设。**编程智能体任务里,语义相近的近 miss 材料比同样 token 数的无关材料更 degrade 证据使用。
根据是 Context Rot 对相关与无关添加的区分。推测的是它迁移到智能体形状的包且大小顺序成立。无关 filler 和近 miss 材料一样伤,假设 weaken;在测试条件下没添加材料条件和基线不同,不支持。过时是单独变量,第 20 章 处理,所以这里近 miss 值优先于被取代的文档,除非时间有效性被控制。
**本书假设。**智能体形状包的位置敏感可能和静态文档 U 形不同,因为智能体包按时间排序,parts 语义 role 不同。
这是待测的预测,不是 established 的差别。模式能是 U 形、primacy、recency、单调趋势、和内容类型的互动,或无稳定 effect,设计测够位置找出来。测试条件下没稳定位置 effect,假设不支持。
提议的实验
本节什么都没跑。companion 仓库有设计,执行 deferred。两实验家族分开:A 里添加材料类型是主要 manipulation,B 里位置是主要 manipulation。两边任务 fixture 是 generalization 评估的单位;一 fixture 上重复跑估计 fixture 内 variability,不是额外的独立任务。报告 fixture 数、条件、重复跑、模型版本、跨 fixture 聚合的分析。执行 state 可能引入顺序 effect 处随机或平衡条件顺序。
**实验 A:添加上下文干扰。**任务、关键证据、模型版本、设置、指令、可用工具固定。无添加基线对比等长添加:无关 filler、topical 相关非答案材料、近 miss 干扰。用单独定义的 neutral-padding 条件估计加长度(无 targeting 语义关系)的 effect;没测 neutral padding 行为 inert 就别断言。加的 token 即使绝对位置固定也能移动关键证据的归一化位置,所以两位置都报告,可行处加位置匹配 control。条件跨任务 fixture 随机,区分意图与观测 token 数在组装边界。测任务成功、不支持的断言、abstain、干扰内容采用。用单独 label 的探针评估在场、可定位、可用,不把探针当没变原任务的观测。
梯度出现,支持添加上下文干扰迁移进测试的任务。所有条件表现一样,合成干扰证据这些条件下没迁移,书报告并删掉断言。无关 filler 和近 miss 材料一样伤,干扰 specific 的动机 weaken。什么都不 degrade,那就是结果。
**实验 B:位置敏感。**证据文本、周围材料、模型、设置、评估目标 hold constant,关键证据移到几个预先指定的归一化位置。可行处用固定长度槽或保位置交换,移动不顺带加减实质材料。报告实际渲染 token 位置、总长度、难免的格式变化;检查移动证据改变它的 role、来源包装、权威性 cues 否。条件跨 fixture 与重复跑平衡,测够位置区分 plausible 模式,不提前 assumed 头中尾 U 形。
位置重要,第 6 章从这个实验拿经验动机。不重要,第 6 章靠别的证据,不能引它。形状随模型任务变,位置政策须条件化不能通用。
在 Context Viewer 里检查
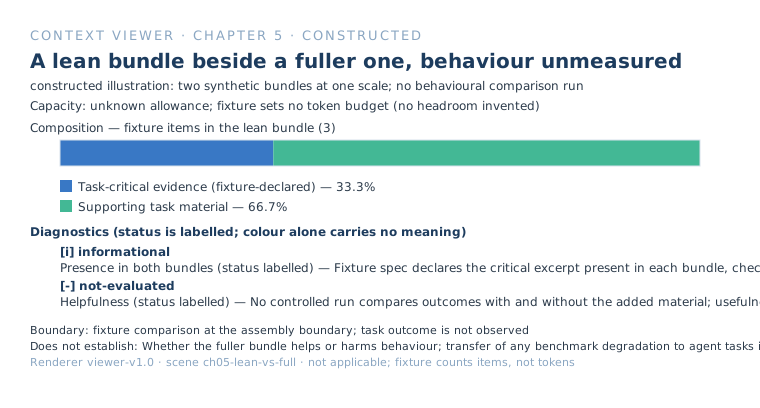
本章的 viewer scene 并排两合成包:三条目的 lean 包和六条目的 fuller 包,同样关键证据加声明的干扰 filler 材料。打开 scene 确认结构上差什么。看什么:fixture 声明哪几条任务关键,fuller 包里它们占多少。没测结果,在场不蕴含这里有帮助;更多是否有帮助是[第 26 章](/zh-cn/books/context/26-chapter/)的问题,不是这个 scene 的答案。
问题留在哪
fit 必要远远不够。文献说明 advertised 上限下性能在特定测试里掉,掉多少看任务模型条件指标。受控研究支撑位置能影响行为、添加周围材料能降性能的断言。它们没确立智能体包也一样,本书自己的实验须先测,迁移才成书的结果。
本章结尾链延长[第 4 章](/zh-cn/books/context/04-chapter/)的 “can fit ≠ should admit ≠ will help”:
在场 ⇏ 可定位 ⇏ 可用 ⇏ 有帮助
位置能重要,它就是候选 control 变量,顺序是系统决定或任其发生。那是下一章的主题:
即使知道包里该装什么信息,放哪?
参考
- Kamradt, G. “Needle In A Haystack.” Third-party evaluation repository, original runs November 2023. Origin of the needle test. https://github.com/gkamradt/needle-in-a-haystack
- Liu, N. F., Lin, K., Hewitt, J., et al. “Lost in the Middle: How Language Models Use Long Contexts.” Transactions of the Association for Computational Linguistics 12 (2024): 157–173; arXiv:2307.03172 (2023 preprint). Peer-reviewed. https://arxiv.org/abs/2307.03172
- Hsieh, C.-P., Sun, S., Kriman, S., et al. “RULER: What’s the Real Context Size of Your Long-Context Language Models?” COLM 2024; arXiv:2404.06654. Peer-reviewed. https://arxiv.org/abs/2404.06654
- Yen, H., Gao, T., Hou, M., et al. “HELMET: How to Evaluate Long-Context Language Models Effectively and Thoroughly.” ICLR 2025; arXiv:2410.02694. Peer-reviewed. https://arxiv.org/abs/2410.02694
- Modarressi, A., Deilamsalehy, H., Dernoncourt, F., et al. “NoLiMa: Long-Context Evaluation Beyond Literal Matching.” ICML 2025; arXiv:2502.05167. Peer-reviewed. https://arxiv.org/abs/2502.05167
- Hong, K., Troynikov, A., Huber, J. “Context Rot: How Increasing Input Tokens Impacts LLM Performance.” Chroma technical report, 14 July 2025. Not peer-reviewed; open codebase. https://www.trychroma.com/research/context-rot
- Anthropic. “Context windows.” Official documentation, verified September 2026. Context rot named; accuracy and recall degrade as token count grows. https://platform.claude.com/docs/en/build-with-claude/context-windows
- Anthropic Applied AI team. “Effective context engineering for AI agents.” Published 29 September 2025. First-party engineering guidance; the finite attention budget framing is its own. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Breunig, D. “How Long Contexts Fail.” 22 June 2025. Practitioner synthesis; four failure modes and mitigation taxonomy. https://www.dbreunig.com/2025/06/22/how-contexts-fail-and-how-to-fix-them.html