把窗口做大
问更强的长上下文模型消除、减少还是搬移上下文管理问题:模型侧机制改变什么和只有运行时能决定的分开。
七章把模型当固定地基,问周围系统怎么对它管理信息。自然的反对从第 4 章等到现在:上下文又缺又难管,为什么不把窗口做大得多?
想象团队把智能体搬到百万 token 模型。场景是说明。以前要剪枝的历史装下了,以前要 triage 的文件能全收了,压缩 schedule 变 quiet。一阵子,上下文工程像等便宜容量的临时措施。
认真对待这个回应,因为它部分对。更大的 provider 窗口装下以前违反硬上限的输入,运行时可能跟着抬自己的准入上限。那是两处分开的变化:换更大的模型不自动改变 harness 决定准入多少的政策。更便宜的处理也能放松成本约束。但装得下不是有帮助,第 4、5 章已经分开两者。反对还把四件不同的事跑在一起:
配置或 advertised 容量
        ≠
计算效率
        ≠
训练出的能力
        ≠
有效行为使用
每样都要真工程才拿到,拿到一样不拿到另几样。本章看模型侧能改变什么,带回后面全书依赖的边界:更大的窗口 ≠ 上下文问题解决。
模型侧的轴
第 1 章用四维度描述上下文包,全描述包和组装它的运行时。第 8 章加不同种类的东西:不是包的第五维度,是接口的另一边。
运行时                    模型侧
决定呈现什么               决定那个表示
表示                     怎么处理

  选择                     模型侧机制的例子:
  排序                     注意力变体
  保留                     循环或有界 state
  外化                     state 压缩
  检索                     位置机器

                  行为
         取决于两边
右列是可能的机制,不是通用流水线。循环有的结构有、有的没有,注意力能稠密稀疏线性混合,历史的表示设计间不同。行为取决于两边,任一边都不能宣布战胜另一边。更便宜的模型侧放松运行时的约束,去不掉它的决定。
长上下文为什么贵
从大窗口难的成本结构开始。常规稠密因果自注意力里,处理整序列涉及 query 位置和前面 key 位置的互动,序列变长注意力互动 work 大致二次。这是 prefill 注意力成分的描述,不是整服务的经验 scale law。前馈算子、混合专家路由、注意力核、内存带宽、batching、硬件能让总算子、延迟、价格 scale 不同。分组 query 注意力主要减少 key-value 头数与缓存代价;tiling 主要改变内存流量,两者都不该说成去掉稠密注意力互动的二次计数。长上下文结构 targeting 成本结构的不同部分。
内存是第二种货币。常规缓存自回归注意力里,不重算过去生成每新 token 须留看过的 token 的 key value state,即 KV 缓存。很长序列下那个 state 能成主要推理内存约束,多少看结构模型硬件 batch。不是每结构都留常规逐 token 缓存,后面节展示。
长上下文在处理提示词和生成 token 时代价能不同,改善一头的机制不一定同样改善另一头。本章对推理工程要这些就够。
移动代价的四种办法
长上下文能力靠几种机制 enable 或更经济。下面四个是有用的区分,但单独不足以确立某 advertised 窗口或其有效行为 reach:
- 扩展位置范围让模型表示训练过的位置之外。
- 降低 state 代价把长序列的历史存更少内存。
- 降低互动代价把贵算子花在全注意力碰的东西的一小部分。
- 改变历史的表示把 ever 增长的 token 历史换成有界或循环 state。
它们重叠。机制能同时降 state 与互动代价,循环 state 最好看成改变两者的不同结构家族,不是严格独立的第四杠杆。分解比任何厂商长寿,provider 只当 worked 例子出现,日期到 2026 年 9 月。
| 机制 | 直接改变 | 例子 | 引入的约束 | 行为问题 |
|---|---|---|---|---|
| 位置扩展 | 可表示的位置范围 | Qwen3 加 YaRN | 改过的位置映射 | 扩展位置质量保得住吗? |
| state 压缩 | state footprint 与表示 | DeepSeek V4 | 历史的压缩表示 | 哪些区分活下来? |
| 稀疏互动 | 贵互动的次数 | DeepSeek V4 | 不是每位置同等算子 | 什么相关信息 miss 了? |
| 有界或循环 state | 历史怎么表示、state 怎么 scale | Kimi Linear、Kimi K3 | 总结历史的有界 state | 哪些历史细节还可用? |
列把机制事实和行为后果分开,这个分开是本章的不变量:机制算什么不告诉我们模型拿它做什么。
位置不是容量
很多当代开源 transformer 家族用旋转位置嵌入(Su 等的构造),旋转矩阵编码绝对位置、注意力里带相对位置依赖。训练长度用、远超它用的模型遇到没学过的位置,质量能为和注意力代价无关的原因受损。YaRN(Peng 等)是建在旋转嵌入上的有影响的扩展法之一。作者报告比以前的方法少约十倍 token、2.5 倍训练步,报告微调长度外推。
Qwen 的文档分开很多页面 blur 的数。Qwen3-8B 模型卡说原生上下文 32,768 token,YaRN 扩展到 131,072,缩放因子四。它警告有的推理框架实现静态 YaRN,每长度同样因子,可能影响短输入。2507 代 Qwen serving 文档展示上下文长度 flag 262,144,建议按可用 GPU 内存选值。那个 flag 描述部署模型的 serving 配置;它本身没确立训练范围、上限处验证精度、Qwen 权重的通用属性。
所以四样东西不同:
训练机制
    ≠
配置的最大值
    ≠
外推的上下文
    ≠
有效可用的上下文
训练机制是模型训练见过的东西,可能是长度分布不是一数。配置的最大值是 serving 设置允许的。外推的上下文是位置缩放够到的。有效可用的上下文是[第 5 章](/zh-cn/books/context/05-chapter/)的证据梯子要的,看任务位置干扰评估。扩展位置范围本身不降 state 或互动代价,没确立有效使用。
压缩与选择
state 压缩问表示以前 token 花什么,稀疏注意力问每 query 贵互动要多少。DeepSeek V4 技术报告(2026 年 4 月提交)把两者描述成交错混合,附发布的模型 artefact 与推理代码。它的压缩稀疏注意力把块压成表示,learned indexer 选候选做更贵的注意力。重压缩注意力用更高的压缩率。两者都含没压缩的局部滑窗分支,作者关联建模局部依赖。大 V4 变体作者报告单 token 推理 FLOPs 是 V3.2 对比的 27%、百万 token 下 KV 缓存用量 10%。这些是那个对比下的厂商报告测量,不是独立测量,也不是某 distant 事实可用的证据。
两观察跟出来。压缩改变后面算子经以访问历史的表示,保真问题须评估不能 assumed 掉。比原来小的表示必然丢掉区分一些可能输入的能力,除非别的信息留别处;那不意味着它丢特定任务要的区分。恰当的行为问题是要求的信息在指定任务长度位置下可恢复可用否。
稀疏选择在模型里造第二个选择问题,和运行时的准入问题不同。运行时选呈现什么材料;稀疏注意力选(或参与定)哪些内部表示拿特定算子。运行时漏掉关键指令和模型收到但没用,可能产出同样的可见失败,前者检查组装包确立,后者没模型侧证据归因不到稀疏路由。内部路由在[第 5 章](/zh-cn/books/context/05-chapter/)的梯子里不是观测步骤。distant decisive 块有效互动太少的说法可测假设,不是 DeepSeek V4 或稀疏注意力一般的 demonstrated 失败。
滑窗分支还制造结构不对称:新 token 有不依赖稀疏选择的直接局部路,distant token 没有。报告没说这是对上面风险的 defence,这里不推断设计者的动机。
经有界 state 记住
Kimi 的结构改变一些层表示历史的方式。常规 token 缓存注意力里 KV 缓存随序列长;Kimi Delta 注意力(Kimi Linear 报告与代码描述)用循环或线性注意力式 state,Gated DeltaNet 扩展加更细 gating。结构把这些层和多头 latent 注意力组合。Kimi Linear 作者报告相对全注意力基线百万 token 下 KV 缓存用量少 up to 75%、解码吞吐高 up to 六倍,报告的 setup 下。Kimi K3 仓库另描述 93 层混合(69 层 Kimi Delta 注意力、24 层门控 latent 注意力层)、2.8 万亿 total、1040 亿激活参数、1,048,576 token 上下文上限。这些是不同发表 artefact 的描述;Kimi Linear 效率结果不能静默当整个 Kimi K3 部署的测量。
两 caution 适用。单个循环部件的 state 不必随前面 token 数线性长,但 Kimi K3 混合还有全局注意力层与 serving 开销。固定尺寸的部件不是固定内存的整模型。更根本,有界 state 留不住无界输入历史任意细、可独立恢复的细节。保留任务要的特定事实否是经验的,state 尺寸 alone 读不出来。发表的结构描述算子与存储在哪;它不证明 distant 细节可靠回忆。
模型侧压缩不是保留政策
[第 7 章](/zh-cn/books/context/07-chapter/)的保留政策显式讲要求:保真下限、声明的政策 standing、任务 state、恢复义务。模型侧压缩是内部表示的 learned 变换。两者都改变多少细节随时可用,但只有运行时政策能明示要求具名来源、精确值、管束约束保留或可恢复。运行时明确保留决定也保证不了模型正确用准入条目;[第 5 章](/zh-cn/books/context/05-chapter/)在场和使用的区分还适用。两者跑在不同的信息与控制下:
运行时缩减
    显式政策,可观测的条目语义

模型侧压缩
    learned 表示,运行时政策 opaque
本章不断言模型实现保留政策。运行时的保留清单伸不进模型的 learned 压缩,细区分须经压缩表示保留,后面算子才恢复得了。
同样的分开适用局部性。有的长上下文结构显式区分局部或新近处理和 distant 历史处理,V4 滑窗分支是一例。局部性机制按位置或 learned 表示分配算子,运行时保留政策能用模型侧机制没有的显式语义 metadata:
局部性 ≠ 重要性
路由主要看位置的机制能 favor 新近 trivial 观察而不 favor 更早的管束约束。那是假设,不同结构处理指令不同。它说明位置局部性政策不是语义保留政策,两者都不必对应新鲜度,新鲜度归[第 20 章](/zh-cn/books/context/20-chapter/)。
训练决定学到什么
结构约束哪些算子可用、什么代价。训练 shape 参数怎么学用那些能力。三件事前后相随,别搞混:
结构允许
    ≠
训练暴露
    ≠
评估展示
支持更长序列的结构本身不展示那些长度的 learned 能力,长处可靠检索、推理、位置使用是行为断言,要第 5、26 章的评估。扩展方法换种货币说同样的话:够到更长的位置不是学会用它,Qwen 对静态缩放的 caution 说明代价在别处到来。
闭模型边界
OpenAI、Anthropic 经生产模型暴露很大的窗口,它们的接口、上限、缓存语义、压缩功能是本书合法的证据。它们的注意力结构是另一回事。本章 review 的第一方材料细节不够按上面机制分类它们的生产模型,所以关于它们什么都不 skating。模型侧比较 rests 在有公开报告实现的架构。公开能力不 license 对没文档内部的推断,推断它们的章节拿 evidentiary 纪律换表面完整。
在 Context Viewer 里检查
本章的 viewer scene 在同样 fixture 上对比小配置和大配置:大配置下更多材料装得下,四政策问题(权威性、过时、冗余、范围)在旁边原样不动。打开 scene 分开机器移动的东西和仍要运行时政策的东西。看什么:一边容量成本,一边没决定的治理。装得下不是准入,两者都不是帮忙。
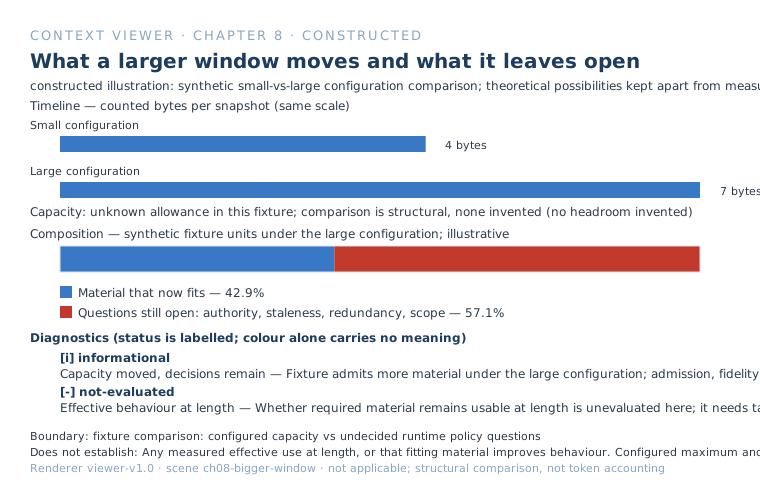
什么变,什么不变
本章的中心问题现在一矩阵回答。假设结构让百万 token 处理近乎免费,检索保真,任何长度不退化。哪些约束动,哪些不动?
| 约束或问题 | 模型变化动它吗? | 去掉运行时决定吗? |
|---|---|---|
| 硬上下文容量 | 动 | 不 |
| 处理成本、延迟 | 动 | 不 |
| KV 或 state 内存 | 动 | 不 |
| 有效长上下文行为 | 看情况,须测量 | 不 |
| 准入什么信息 | 改阈值 | 不 |
| 要求什么表示保真 | 本身不 | 不 |
| 哪个重复冗余 | 本身不 | 不 |
| 哪个来源权威 | 不是底层事实 | 不 |
| 什么信息过时 | 不是底层事实 | 不 |
| 哪个项目范围适用 | 不是底层事实 | 不 |
| 什么外部信息现在回来 | 本身不 | 不 |
改变压力不等于消灭决定。结构 alone 给不了最后几行要的外部政策事实:权威性来自部署政策,新鲜度来自时间戳与来源 state,范围来自外部成员,矛盾的解决来自来源。模型能训练推断预测其中一些,推断不等于事实。边界最强形式是:
处理能力 ≠ 政策知识
本章同等力度拒绝反方向的错。这些都没让长上下文或结构无关。关系是互补:
更高效或更强的长上下文结构
        ↓
改变可行域与成本曲线

更好的运行时上下文政策
        ↓
改变呈现的信息

一起
        ↓
上下文系统
第一方 case 展示同一系统两杠杆。Kimi K3 仓库报告 BrowseComp benchmark:300K token 触发的上下文压缩策略 91.2 分,整百万 token 窗口无管理 90.4。两个点估计,一 benchmark,厂商报告,差小。它只说明大模型侧容量和运行时上下文管理能在一评估系统共存。本章的论点不依赖它,明天 practice 变了也成立:结构控制处理可能与成本,运行时政策控制呈现的信息。
两缓存,不是一
一混淆须在下一章前清掉。模型推理 state(KV 缓存或结构的循环 state)按 serving 实现跨请求的 decode 步骤 persist。provider 的前缀缓存不同:serving 层机制,渲染前缀匹配的跨请求复用算子,自动或显式控制,最小长度 lifetime 各 provider 不同。两者共享词汇,归属、粒度、控制不同:
模型推理 state ≠ 跨请求前缀缓存
为减少准入上下文做的运行时 edit 也缩短或作废前缀匹配缓存方案下的可复用前缀匹配,优化一台账 damage 另一台账。第 9 章拥有细节。
本书不测什么
本章不跑新实验,选择 deliberate。它的主要贡献是概念分解与外部政策内部处理的边界。结构描述引用的技术报告、模型卡、仓库;报告的效率数还是作者评估条件下的断言。配置长度和有效使用的区分由[第 5 章](/zh-cn/books/context/05-chapter/)的外部行为研究支撑,不是由为本书在 DeepSeek V4、Kimi K3 上做的实验。模型结构本身定不了外部来源权威性与任务 specific 准入的断言是关于缺失政策输入的论证,不是关于模型性能的测得预测。
便宜留下的浪费
假设结构完全成功。运行时组装周二的包:指令、项目规则、工具定义、历史、检索文件、新观察、当前请求。周三的调用几乎全收一遍,加一新轮次。没有跨请求复用,稳定前导 span 的处理可能重复。那不意味着每 token 在所有 serving 结构下同样重算,也不意味着特定 provider 两调用计费一样。容量决定装什么;模型效率改变处理它的代价。跨请求重复 work 还是独立的系统问题:
已在可复用前缀上做过的 work 何时安全经济地复用?
参考
- DeepSeek-AI. “DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence.” Vendor technical report, arXiv:2606.19348, April 2026. CSA and HCA hybrid; lightning indexer with top-k selection; sliding-window branch; 27% of single-token inference FLOPs and 10% of KV cache versus V3.2 at 1M (vendor-reported). https://arxiv.org/abs/2606.19348
- Kimi Team. “Kimi Linear: An Expressive, Efficient Attention Architecture.” Vendor technical report, arXiv:2510.26692, October 2025. KDA extending Gated DeltaNet; hybrid with MLA; up to 75% less KV cache and up to 6× decoding throughput at 1M (vendor-reported). https://arxiv.org/abs/2510.26692
- MoonshotAI. “Kimi-K3.” Official repository, verified September 2026. 69 KDA and 24 gated MLA layers; 2.8T total and 104B active parameters; 1,048,576-token context; BrowseComp 91.2 with compaction at 300K versus 90.4 with the full 1M window (vendor-reported). https://github.com/MoonshotAI/Kimi-K3
- Qwen Team. “Qwen3-8B model card.” Hugging Face, verified September 2026. 32,768 native, 131,072 with YaRN; static-scaling caveat. https://huggingface.co/Qwen/Qwen3-8B
- Qwen Team. “Qwen3 documentation (Quickstart).” Verified September 2026. Context length as a serving flag (262,144 in the deployment examples). https://qwen.readthedocs.io/en/latest/getting_started/quickstart.html
- Peng, B., Quesnelle, J., Fan, H., Shippole, E. “YaRN: Efficient Context Window Extension of Large Language Models.” Preprint, arXiv:2309.00071. https://arxiv.org/abs/2309.00071
- Su, J., Lu, Y., Pan, S., Murtadha, A., Wen, B., Liu, Y. “RoFormer: Enhanced Transformer with Rotary Position Embedding.” Preprint, arXiv:2104.09864. https://arxiv.org/abs/2104.09864